Molti ingegneri e informatici che hanno studiato all’università dagli ’90 in poi hanno una sensazione ricorrente quando leggono articoli sull’Intelligenza Artificiale moderna: gran parte delle tecniche presentate come rivoluzionarie sembrano in realtà strumenti già noti da tempo.
Ottimizzazione numerica, statistica, reti neurali, metodi euristici e algoritmi di ricerca erano infatti tecniche e concetti insegnati molto prima dell’attuale boom dell’AI.
C’è quindi qualcosa che non torna, si tratta di teorie “vecchie” o c’è effettivamente qualcosa di nuovo? Le fondamenta matematiche dell’AI moderna non sono nuove. Se con il termine “intelligenza” ci riferiamo ai presupposti teorici di questa tecnologia allora possiamo affermare che esiste ed è insegnata da una trentina d’anni a questa parte, è, però, cambiato il modo in cui tali strumenti vengono utilizzati oggi.
Supponiamo quindi che con il termine “intelligenza” ci si riferisca ai presupposti teorici di questa tecnologia allora per comprenderla oltre l’ideologia è necessario partire da tre pilastri matematici fondamentali: statistica, ottimizzazione ed euristica.
I tre pilastri matematici dell’AI
-
La statistica si occupa di estrarre informazione dai dati. Quando stimiamo una probabilità, una distribuzione o una correlazione stiamo svolgendo un problema statistico. In un sistema di riconoscimento immagini, ad esempio, la statistica consente di individuare regolarità nei milioni di esempi utilizzati per l’addestramento di un nuovo modello. La statistica non è una scienza esatta, si basa sulla probabilità e non sulla certezza, ma se il campione è abbastanza vasto da coprire una buona parte della popolazione presa in esame, allora le sue predizioni diventano sempre più accurate. Negli anni ’90 ad esempio non c’era modo di accumulare una quantità di dati sufficiente per analizzare con un errore trascurabile i fenomeni fisici, economico o sociali… figuriamoci se poteva essere possibile memorizzare miliardi e miliardi di libri, immagini e altro per ridurli a dati da cui estrarre delle statistiche. Ci tornerò successivamente ma in questo fatto sta uno dei cambiamenti storici che porta l’AI a diventare così centrale oggi.
-
L’ottimizzazione ha invece un obiettivo diverso: trovare la soluzione migliore rispetto a una funzione obiettivo. In termini matematici si cerca il minimo o il massimo di una funzione:
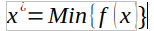
oppure
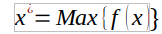
Quando una rete neurale viene addestrata, ciò che realmente accade è la minimizzazione di una funzione di errore.
Facciamo un esempio per semplificare e capirci meglio. Un modello di AI basato sul linguaggio – ovvero i LLM – deve costruire una frase sulla base di una domanda. Poniamo una domanda semplice: “Come stai?” , il modello andrà a cercare qual è, tra i tanti dati raccolti, la prima parola più probabile che si ripete dopo questa domanda e troverà: “Sto”.
Successivamente cerca qual è la parola seguente più probabile – senza perdere il contesto della domanda – e troverà: “bene”. Fino ad arrivare a rispondere “Sto bene. Grazie!”, semplicemente perché ha notato che questa è la risposta che è statisticamente più probabile nelle conversazioni e nei dialoghi dai quali ha appreso.
Quindi sulla base di una statistica e di un numero enorme quantità di dati attiva una funzione di ottimizzazione che restituisce appunto un ottimo (minimizzazione dell’errore o massimizzazione della probabilità etc etc) in corrispondenza di alcune soluzioni come ad esempio quella proposta.
Questa tecnica è importante perché ci fa comprendere che l’AI segue degli obiettivi prefissati, e attiva tutti i percorsi utili a raggiungere questi obiettivi.
-
Le euristiche, infine, sono strategie pratiche utilizzate quando il problema è così complesso da rendere impossibile una ricerca esatta della soluzione ottimale. Invece di esplorare tutte le possibilità, l’algoritmo utilizza regole di buon senso matematicamente motivate per restringere lo spazio di ricerca. Di fatto, alla domanda precedente un modello avrebbe potuto rispondere in mille altri modi ma calcolare esattamente quale sarebbe il modo perfetto per rispondere potrebbe richiedere troppo tempo allora invece di usare la soluzione “ottima” in assoluto si utilizzano tecniche capaci di arrivare ad “ottimi” relativi, ovvero soddisfacenti ma non assolutamente esatti. In questa immagine, la pallina nel punto A si trova in un ottimo relativo, la pallina nel punto B in un ottimo assoluto quando la funzione obiettivo è minimizzare l’altezza a cui si trova la pallina. Una euristica che ci porterebbe nel punto A è la regola di andare avanti fin tanto che non trovo una salita. Come è evidente rispetto al punto di partenza non ci si sbaglia di molto se invece che andare nel punto di ottimo assoluto ci si ferma in quello relativo, si risparmia però tempo.
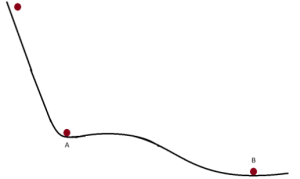 Gran parte dell’AI moderna può quindi essere descritta come la combinazione di questi tre elementi: la statistica estrae informazione dai dati, l’ottimizzazione definisce l’obiettivo da raggiungere e le euristiche permettono di trovare una soluzione, seppur approssimata, in tempi accettabili.
L’apprendimento delle macchine esiste già negli anni ’50
Una convinzione diffusa è che le reti neurali siano una tecnologia recente. In realtà il loro antenato diretto, il Perceptron, fu introdotto da Frank Rosenblatt nel 1958 nel lavoro The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain. [homepages….th.uic.edu], [mlanthology.org]
L’idea fondamentale era già quella di un sistema capace di modificare automaticamente i propri parametri sulla base dell’esperienza. In altre parole, il concetto di apprendimento dai dati era presente oltre sessant’anni fa. [homepages….th.uic.edu], [mlanthology.org]
Anche molte tecniche di ottimizzazione utilizzate oggi derivano da idee sviluppate nel corso del Novecento. Da questo punto di vista, affermare che l’AI sia nata negli anni ‘20, con OpenAI ad esempio, sarebbe storicamente scorretto.
Le euristiche erano già considerate AI
Un altro esempio significativo è rappresentato dall’algoritmo A*, introdotto nel 1968 da Peter E. Hart, Nils J. Nilsson e Bertram Raphael nel lavoro A Formal Basis for the Heuristic Determination of Minimum Cost Paths. [centerconsulting.com], [achievements.ai]
L’algoritmo utilizza una funzione:
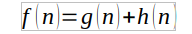
dove g(n) rappresenta il costo reale accumulato mentre costituisce una stima euristica del costo ancora necessario per raggiungere l’obiettivo. L’idea consiste nel privilegiare i percorsi che sembrano più promettenti. [achievements.ai], [centerconsulting.com]
Questa logica è alla base di numerosi sistemi di pianificazione, robotica e navigazione ancora oggi utilizzati. Pertanto, molti degli strumenti che oggi chiameremmo AI erano già presenti oltre mezzo secolo fa. [en.wikipedia.org], [centerconsulting.com]
La differenza più interessante tra AI classica e Large Language Models (LLM) non è tanto nella matematica utilizzata, quanto nel luogo in cui risiede la conoscenza, o se vogliamo l’intelligenza.
AI classica
Nei sistemi tradizionali l’intelligenza era principalmente incorporata dal progettista.
L’ingegnere definiva:
- le regole del sistema;
- le euristiche da applicare;
- le funzioni di valutazione;
- i criteri decisionali.
In un motore scacchistico classico, ad esempio, era il progettista a stabilire che una donna valeva più di una torre o che il controllo del centro della scacchiera fosse vantaggioso. Il sistema eseguiva ciò che era stato esplicitamente modellato dall’essere umano in maniera consapevole. In questo paradigma si può affermare che l’intelligenza risiedesse principalmente nel progettista.
Large Language Models
Negli LLM la situazione è profondamente diversa. L’ingegnere non programma più direttamente le regole linguistiche. Non scrive la grammatica italiana, inglese o francese. Non definisce manualmente quando utilizzare una determinata costruzione sintattica.
Definisce invece:
- l’architettura del modello;
- la funzione di perdita (loss function);
- il processo di addestramento;
- le procedure di ottimizzazione.
Successivamente il sistema apprende autonomamente osservando enormi quantità di dati.
In questo paradigma, l’intelligenza non risiede principalmente nelle regole scritte dal progettista, ma nei dati e nel processo di apprendimento che consente di estrarne regolarità, schemi e conoscenze implicite. L’ingegnere non programma direttamente il comportamento finale del sistema; programma piuttosto il meccanismo attraverso il quale tale comportamento emergerà.
Questo rappresenta probabilmente il cambiamento concettuale più importante introdotto dall’AI moderna.
Ma da dove provengono i dati necessari per addestrare questi modelli? In larga misura dalla produzione culturale e conoscitiva dell’umanità: libri, articoli, siti web, fotografie, opere artistiche, documentazione tecnica, discussioni pubbliche, archivi digitali e, più in generale, dalla conoscenza accumulata e trasmessa da generazioni. La proprietà di questi dati è collettiva.
È proprio qui che emerge una delle tensioni più significative dell’industria dell’intelligenza artificiale contemporanea. Le prestazioni dei modelli dipendono fortemente dalla quantità e dalla qualità dei dati disponibili, e dalla capacità di archiviarli. Di conseguenza, la competizione tra aziende si traduce spesso nella ricerca di un accesso sempre più ampio al patrimonio informativo prodotto collettivamente dalla società.
Si crea così un paradosso: il valore economico dei modelli deriva in misura crescente dalla capacità di incorporare e rielaborare conoscenze generate da milioni di persone, mentre i benefici economici risultanti tendono a concentrarsi nelle organizzazioni che possiedono l’infrastruttura computazionale, i modelli e le piattaforme attraverso cui tali conoscenze vengono trasformate in prodotti e servizi.
La questione diventa quindi non solo tecnologica ma anche politica, economica e giuridica: chi possiede la conoscenza, chi può utilizzarla per addestrare modelli di AI e chi dovrebbe beneficiare del valore economico generato da tale utilizzo?
In altre parole, il dibattito contemporaneo sull’intelligenza artificiale non riguarda soltanto gli algoritmi, ma anche il rapporto tra conoscenza collettiva e proprietà privata.
Da questo punto di vista siamo di fronte a due modelli politicamente diversi: quello cinese open source e quello privatistico americano. Su ognuno di questi modelli insiste una contraddizione: per quello cinese è vero che il software di intelligenza artificiale è gratis/aperto, ma per usarlo è necessario un server non certo alla portata di una famiglia e spesso nemmeno di alcuni Stati.
Sul modello americano insiste la contraddizione più classica del capitalismo: affinché la conoscenza possa diventare proprietà privata, è necessario negare la proprietà privata sulla conoscenza ai singoli individui. Ovvero devono operare costantemente espropriazioni del prodotto del lavoro mentale.
Qui si capisce anche perché alcuni sviluppatori AI sembrano essere impazziti, mollano tutto per paura di ciò che potranno essere gli effetti dell’intelligenza artificiale in futuro, non la comprendono più… Il punto è che il capitale ha prodotto alienazione tra chi lavora per ottenere una merce e chi invece se ne appropria, esattamente come un operaio che produce un ingranaggio di una macchina su cui non ha nessun controllore consapevolezza, così succede per gli ingegneri oggi.
A quel famoso sviluppatore diventato estraneo al prodotto del suo stesso lavoro andrebbe detto: benvenuto nell’era dell’AI, benvenuto nella classe operaia. Magari, con un po’ di sano marxismo gli passa la paura
Conclusioni
Resta un punto ancora da sviscerare, se le basi dell’AI esistevano anche nei primi anni 2000, perché ora se ne parla così tanto? Il punto di svolta avvenne nel 2012 con il lavoro ImageNet Classification with Deep Convolutional Neural Networks di Alex Krizhevsky, Ilya Sutskever e Geoffrey Hinton. Il modello dimostrò come una rete neurale profonda addestrata su oltre un milione di immagini e accelerata tramite GPU potesse superare nettamente le tecniche precedenti. [proceeding…neurips.cc], [papers.nips.cc]
La successiva svolta arrivò nel 2017 con il lavoro Attention Is All You Need di Ashish Vaswani e collaboratori, che introdusse l’architettura Transformer utilizzata dai moderni LLM. [arxiv.org], [research.google], [papers.neurips.cc]
La matematica sottostante non era nuova. Ciò che era cambiato era la disponibilità simultanea di:
- grandi quantità di dati;
- elevata potenza computazionale;
- architetture sufficientemente scalabili.
Ciò che cambia è la scala. Modelli con centinaia di miliardi di parametri vengono addestrati su quantità di testo impensabili solo pochi anni fa. [arxiv.org], [papers.neurips.cc]
C’è stato quindi un cambio di paradigma. Nell’AI classica l’intelligenza era codificata dall’ingegnere sotto forma di regole ed euristiche; nei moderni sistemi di apprendimento l’ingegnere definisce l’architettura e il processo di ottimizzazione, mentre la conoscenza emerge dall’analisi di enormi quantità di dati.
È questo spostamento dell’intelligenza dalle regole ai dati, unito alla disponibilità di potenza computazionale senza precedenti, che ha trasformato “vecchie” idee accademiche in una rivoluzione tecnologica percepita oggi come “Intelligenza Artificiale”. [proceeding…neurips.cc], [arxiv.org], [papers.neurips.cc]
Venendo quindi a una delle questioni più filosofiche: l’AI possiede una coscienza autonoma oppure no? La risposta è semplice se si guarda appena dietro all’ideologia che costruiscono attorno a questa tecnologia:
1. L’intelligenza, ovvero la matematica di base, è molto simile al T9 dei vecchi telefoni, nessuno mai ha creduto che il telefono pensasse prima di completare le parole;
2. La conoscenza deriva dall’enorme capacità di rubare dati, di memorizzarli e catalogarli. L’AI è cosciente solo di quella che è la conoscenza umana. Può apparire che abbia consapevolezza di se stessa, ma questa è ideologia, la macchina sta solo ripetendo uno schema che ha trovato ripetibile staticamente e vincente (“ottimo”) nel comportamento umano.
3. Non è possibile prevedere a priori come reagirà un certo modello in seguito all’addestramento semplicemente perché il nostro cervello è troppo limitato per tener conto di tutti quei dati contemporaneamente, ed emerge così l’angoscia di non riuscire a tenere sotto controllo l’AI. Quando invece quel comportamento è semplicemente il miglior comportamento mai realizzato dall’umanità, individuato in tempi utili in funzione di uno o più obiettivi dichiarati in partenza. È il caso degli esperimenti che sono sulle cronache dei giornali, quando si dice che il modello tal dei tali abbia disobbedito ha in realtà riprodotto uno schema che ha trovato in un forum di hacker per esempio.
Al di là dell’ideologia la realtà è ben diversa: ciò che è fuori controllo è il modo di produzione capitalista, che porta ad un nuovo e rinnovato livello l’alienazione, mentre i produttori di conoscenza (i lavoratori) cadono nel girone della classe operaia, insieme alle illusioni offerte dal capitalismo.
È chiaro però che se addestri un modello con i manuali di guerra invece che con quelli medici, sarà potenzialmente in grado di distruggere l’umanità.
Ma la responsabilità di chi è? Vogliamo davvero pensare che sia di un pezzo di silicio a decidere tutto?
Bibliografia scientifica
- Frank Rosenblatt, The Perceptron: A Probabilistic Model for Information Storage and Organization in the Brain, Psychological Review, 1958. [mlanthology.org], [homepages….th.uic.edu]
- Peter E. Hart, Nils J. Nilsson, Bertram Raphael, A Formal Basis for the Heuristic Determination of Minimum Cost Paths, IEEE Transactions on Systems Science and Cybernetics, 1968. [centerconsulting.com], [achievements.ai]
- Alex Krizhevsky, Ilya Sutskever, Geoffrey E. Hinton, ImageNet Classification with Deep Convolutional Neural Networks, NeurIPS 2012. [proceeding…neurips.cc], [papers.nips.cc]
- Ashish Vaswani et al., Attention Is All You Need, NeurIPS 2017. [a<span style=”font-family: Liberation Serif, serif;”><span style=”font-size: large;”>rxiv.org], [research.google], [papers.neurips.cc]
- © Riproduzione possibile DIETRO ESPLICITO CONSENSO della REDAZIONE di CONTROPIANO
Ultima modifica: stampa